Как подключить ИИ к 1С/CRM: приватный LLM вместо ChatGPT
Инструкция по внедрению приватного ИИ (RAG, LLM) в бизнес-процессы. Снижение рисков, интеграция с 1С и CRM. Цены и пошаговый план.
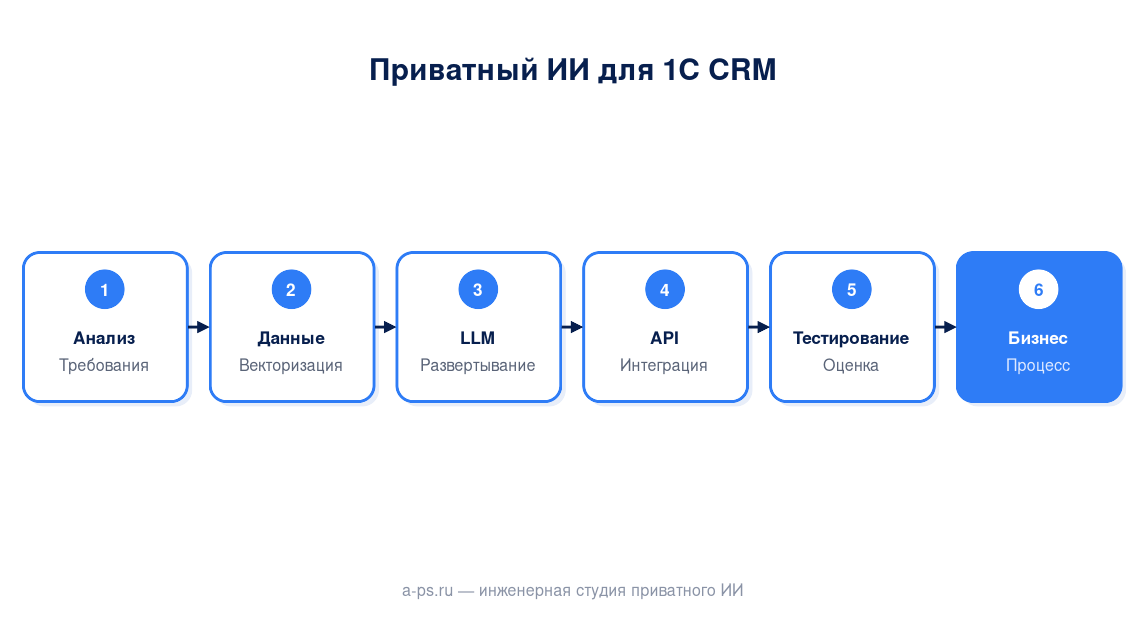
Проблема: почему ChatGPT не подходит для бизнеса
Многие компании ошибочно считают, что публичный ChatGPT решает их задачи. Однако для работы с конфиденциальной корпоративной информацией он представляет неприемлемый риск, а не готовый инструмент. При вводе коммерческой тайны, клиентских баз или внутренней финансовой отчетности данные мгновенно покидают защищенный периметр компании и отправляются на серверы OpenAI.
Это не просто риск, а нарушение требований российского законодательства о защите персональных данных (ФЗ-152). Публичный ИИ не гарантирует локализацию данных, что делает его непригодным для регулируемых отраслей (финансы, госсектор, медицина).
Рассмотрим практические ограничения:
- Отсутствие интеграции: ChatGPT не имеет нативной связи с 1С, ERP или внутренними CRM-системами, где хранятся ключевые данные.
- Неконтролируемый расход: Стоимость привязана к объему токенов (например, $0.001/1000 токенов), что делает прогнозирование бюджета невозможным при резком росте нагрузки.
- Ограниченное знание: База знаний ChatGPT статична и не содержит уникальных корпоративных регламентов, прайсов или истории взаимоотношений с клиентами.
В результате, использование ChatGPT для критически важных бизнес-процессов приводит к двойному ущербу: утечке данных и некачественному, неконтекстному результату. Решение — переход на приватный ИИ, где LLM работает исключительно с локально подготовленной корпоративной базой (RAG) и интегрирован через API в существующую ИТ-инфраструктуру.
Что нужно и сколько стоит внедрение приватного ИИ
Для успешного внедрения приватного ИИ необходим не только сам LLM, но и три ключевых компонента: корпоративная база знаний (для RAG), вычислительная инфраструктура и интеграционный слой (API-обертка для 1С/CRM). Без этих элементов модель останется изолированной и не сможет работать с вашими реальными данными.
Минимальный набор для MVP (проверка гипотезы):
- Очищенная база знаний (до 50 ГБ).
- Локальный LLM (например, Llama 3 8B) на GPU уровня RTX 3090 (24 ГБ VRAM).
- Интеграция через Python-скрипт. Стоимость: 150 000 – 300 000 руб. (оборудование + настройка).
Масштабирование (корпоративный уровень): Требуется выделенный сервер (NVIDIA A100 или H100 в облаке, например, Yandex Cloud/Sber Cloud) и полноценный RAG-пайплайн с векторной базой (PostgreSQL pgvector). Стоимость: 500 000 – 1 200 000 руб. (включая 3 месяца облачного хостинга и разработку).
Самый дорогой сценарий (полная интеграция 1С): Включает выделенный кластер, тонкую настройку (fine-tuning) модели под специфический бизнес-сленг компании и двустороннюю интеграцию через API в 1С:ERP/УТ. Стоимость: от 1 500 000 руб. и выше.
Важно: стоимость — это не только железо. Около 40% бюджета приходится на подготовку данных (очистка, структурирование) и 30% — на разработку надежного API-слоя, который связывает ИИ с вашими учетными системами. Не экономьте на интеграции, иначе ИИ будет бесполезным «островом».
Этап 1: подготовка корпоративных данных (RAG)
Подготовка корпоративных данных — это не просто сбор файлов, а структурирование неструктурированной информации для эффективного векторного поиска. Основная задача RAG — преобразовать текстовые документы (PDF, DOCX, базы 1С) в числовые векторы, понятные LLM.
Сбор источников начинается с выгрузки данных из 1С (например, справочники, регламенты) в стандартизированный формат (JSON/TXT). Ручные или полуавтоматические процессы OCR (например, с использованием Tesseract или облачных API) используются для сканированных архивов.
Ключевым шагом является чанкинг — разбиение больших документов на смысловые, компактные блоки. Рекомендуемый размер чанка: 512–1024 токена с перекрытием 10–20% для сохранения контекста между фрагментами. Чанки должны быть минимально достаточны для ответа, но не слишком малы, чтобы не потерять контекст.
После чанкинга данные проходят этап эмбеддинга. Выбирается модель (например, русскоязычные SBERT или специализированные модели от российских вендоров). Процесс выполняется скриптом (Python, LangChain) и результат — векторы — сохраняется в векторной базе данных (Qdrant, Milvus или PostgreSQL с расширением PGVector).
Пример: регламент на 15 страниц (около 30 000 токенов) разбивается на 60–75 чанков, каждый из которых занимает менее 1 кб. Это позволяет снизить стоимость запроса к LLM в 3-5 раз по сравнению с передачей целого документа.
Этот этап занимает от 1 до 3 дней для базы объемом до 500 МБ, в зависимости от качества исходных данных. Некачественный чанкинг (слишком большие блоки) приводит к "размыванию" ответа ИИ.
Этап 2: выбор и настройка приватного LLM (локально/облако)
Выбор платформы зависит от объёма данных и требований к задержке. Локальное развертывание (on-premise) гарантирует максимальную безопасность, но требует мощного железа (минимум 16 ГБ VRAM для Llama 3 8B). Облако подходит для быстрого масштабирования без капитальных вложений, но требует строгой изоляции данных.
Для локального старта рекомендуется использовать инструменты, такие как Ollama или LM Studio. Это упрощает запуск модели (например, Mistral 7B) через локальный API, минуя сложные Docker-сборки. Настройка занимает 2-4 часа, а эксплуатационные расходы — только электроэнергия.
В облаке (Yandex Cloud, VK Cloud) следует арендовать выделенную VM с GPU (например, A100 или T4). Стоимость аренды, включая 4-8 ГБ VRAM, начинается от 15 000 до 30 000 руб./месяц. Важно: настройте VPC и сетевую изоляцию, чтобы данные никогда не вышли за периметр компании.
После выбора платформы, модель (например, Llama 3 8B или GigaChat в корпоративном режиме) загружается и запускается. Настройка сводится к:
- Установке runtime (Ollama/Docker).
- Загрузке весов (файлы
.gguf). - Проверке доступности API (например,
http://localhost:11434/api/generate).
Тестирование должно включать задержку ответа (цель: < 2 секунд) и стабильность при нагрузке 5-10 запросов/сек. Только после подтверждения этих метрик LLM готов к интеграции с корпоративными данными (Этап 3).
Этап 3: интеграция ИИ в 1С/CRM (API-слой)
Интеграция приватного LLM в корпоративные системы 1С или CRM (например, AmoCRM, Битрикс24) осуществляется исключительно через API-слой, минуя прямое взаимодействие с базой данных. Это обеспечивает безопасность и управляемость.
Для реализации требуется создать промежуточный микросервис (на Python/Node.js), который выступает как шлюз между 1С и LLM. Этот шлюз принимает запросы от 1С (через веб-сервисы или HTTP-клиенты) и форматирует их в JSON, соответствующий требованиям LLM-провайдера.
Пример практического сценария: автоматический ответ на входящий запрос в CRM.
- CRM генерирует событие (новое письмо).
- 1С-клиент (или внешний обработчик) вызывает API шлюза, передавая текст письма.
- Шлюз отправляет запрос LLM (например,
POST /api/completionс токеном доступа). - LLM возвращает сгенерированный ответ.
- Шлюз валидирует ответ и через API CRM обновляет статус или публикует готовый текст.
Ключевые технические требования:
- Протокол: REST/HTTP (HTTPS обязателен).
- Аутентификация: API-ключи или OAuth 2.0 (не передавать токены в логах).
- Обработка ошибок: Реализовать механизм таймаута (рекомендуется 5-10 секунд) и повторных попыток (retry logic) для устойчивости.
Успешная интеграция требует от 1С-конфигурации не просто чтения данных, а выполнения исходящих HTTP-вызовов. Протестируйте задержку: при обработке 50 запросов в минуту, средний отклик LLM не должен превышать 3-4 секунд, иначе возникнет "бутылочное горлышко" на шлюзе. Это критично для реального времени.
Подводные камни: безопасность и технические требования
Основной риск при использовании публичных LLM (вроде ChatGPT) — утечка конфиденциальных корпоративных данных, которые отправляются на сторонние серверы. Для соответствия ФЗ-152 и ФЗ-276, данные должны оставаться в защищенном контуре предприятия. Использование облачных сервисов требует тщательной проверки сертификатов (например, ГОСТ-сертификация для критичных данных).
Техническая реализация приватного ИИ требует серьезных ресурсов. Для локального развертывания модели 7B (например, Llama 3 8B) минимально необходима видеокарта с VRAM 12–16 ГБ (например, NVIDIA RTX 3060/4060 Ti) и 32 ГБ оперативной памяти. Запуск на CPU возможен, но приведёт к задержке (latency) более 5 секунд на запрос, неприемлемой для CRM-интеграции.
Интеграционная сложность часто недооценивается. Недостаточно просто вызвать API; необходимо создать защищенный прокси-слой (например, на FastAPI/Python) между 1С/CRM и LLM. Этот слой должен выполнять аутентификацию, валидацию запроса и логирование, предотвращая прямой доступ внешних систем к модели.
Пример технического требования: если требуется обработка 1000 запросов в час с гарантированной задержкой менее 1.5 секунды, минимально необходима кластерная конфигурация (2+ узла) с GPU-ускорением, а не однопоточный локальный сервер. Недостаточная пропускная способность API может привести к сбоям в бизнес-процессах.
Важно учесть: не все российские LLM имеют готовые API-коннекторы для 1С. Часто требуется ручная разработка обертки, что занимает от 40 до 80 человеко-часов, а не просто настройка. Экономия на этапе интеграции приводит к нестабильности системы в эксплуатации.
Чек-лист: внедрение корпоративного ИИ
Успешное внедрение приватного ИИ — это не покупка лицензии, а комплексная техническая интеграция. Прежде чем запускать пилот, необходимо верифицировать готовность инфраструктуры и данных. Проверьте, что база знаний (документы, регламенты) структурирована в формате, пригодном для векторизации (PDF/DOCX с метаданными, а не сканы).
На этапе выбора LLM определите целевую нагрузку: если 50+ одновременных запросов, необходим выделенный GPU-сервер (например, NVIDIA A100) или облачный инстанс (Yandex Cloud/Sber Cloud) с гарантированным SLA. Стоимость минимального развертывания (RAG + API-шлюз) начинается от 350 000 руб./год.
Интеграция с 1С/CRM должна происходить через выделенный API-слой (например, на базе Python/FastAPI), который оборачивает стандартные методы 1С (SOAP/XML), а не через прямое взаимодействие с базой. Это обеспечивает транзакционную целостность.
Проверьте безопасность: все данные должны храниться в защищенном контуре (IP-адресы, VPN), а не в публичном облаке. Убедитесь, что модель не имеет доступа к шифрованным паролям или финансовым реквизитам.
- Определена и векторизована база знаний (min. 500+ документов) для RAG-системы.
- Выбран и протестирован LLM (например, Llama 3 8B или локальный аналог) с подтвержденной пропускной способностью (req/sec).
- Реализован API-шлюз между LLM и 1С/CRM (например, через промежуточный микросервис).
- Проведено тестирование безопасности: подтверждена изоляция данных (отсутствие утечки PII).
- Установлен механизм мониторинга: задержка ответа ИИ не превышает 3 секунд в 95% случаев.
- Оценена TCO (Total Cost of Ownership): расходы на железо/облако + поддержка составили не более 15% от ожидаемого ROI в первый год.
Инженерная студия АПС разворачивает приватный ИИ на инфраструктуре клиента: локальные модели, RAG-поиск, ИИ-агенты под процессы. Данные не покидают контур компании. Опыт с 2012 года — обсудить проект.
Читайте также
Внедрить это в вашей компании
Приватный ИИ, RAG-поиск и агенты на вашем сервере — пилот за пару недель покажет эффект до полного бюджета.
Обсудить проектКомментарии (0)
Пока нет комментариев — будьте первым.